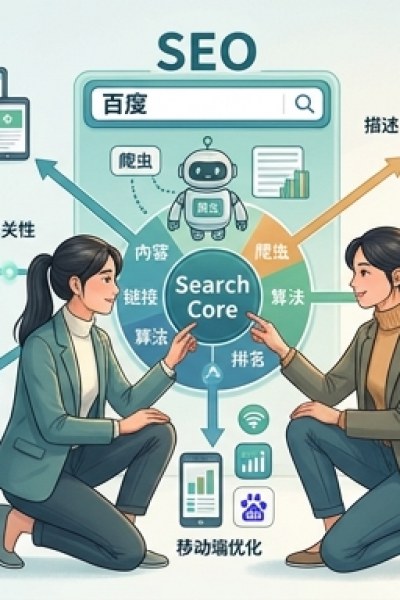
歸美在線seo在SEO场景中若出现蜘蛛身份伪装,就容易让抓取端与真实访问端看到不同页面内容,进而引发索引偏差、权重误判和收录波动;因此应同步校验请求头、访问频率、渲染结果与日志特征,避免将可抓取内容、跳转规则和首屏资源暴露在不一致的链路中,从源头减少伪装带来的排名风险。
在SEO排查中,静态资源误封常被低估,却会直接影响歸美在線seo相关页面的抓取理解与渲染完整度;当CSS、JavaScript、字体或关键图片被robots规则、WAF策略、CDN鉴权或异常响应拦截后,搜索引擎可能只能看到结构残缺的页面版本,进而误判首屏内容、交互可用性与主题相关性,导致收录效率下降、排名波动加剧,甚至让原本可稳定参与排序的歸美在線seo页面进入低质量评估路径,因此需要持续核对资源返回码、抓取日志、渲染快照与封禁规则,确保静态资源对搜索引擎抓取链路保持可访问、可下载、可解析。
在SEO排查中,日志落地延迟会直接干扰对歸美在線seo页面抓取状态的判断:当访问记录写入慢于实际抓取发生时间,分析人员就容易误判抓取频次、响应波动与收录变化之间的先后关系,进而把短时异常当成持续性问题。要降低这种偏差,应同步校准服务器时间、采集链路时间与分析平台入库时间,按批次核对延迟区间,并结合抓取高峰、状态码分布、渲染请求和索引反馈交叉验证,避免因为日志晚到而错误调整SEO策略。